
AUTONOMOUS HYPOTHESIS 01 人类网络
认知自主
大模型作为 AI 科学家副驾,内化海量文献与隐性经验,自主完成意图理解、假设生成、方案设计与报告解读。人只主导目标设定与科学判断
后训练大模型 专利排雷 跨学科检索

AI FOR SCIENCE
高端新材料的研发长期依赖专家试错:算力成本高、实验通量低、数据链路割裂。我们用多智能体集群打通人类网络、科学计算与物理系统,把材料发现、性能预测、工程放大到量产排程连成一个模型驱动的闭环。
INDUSTRIAL AI · AGENTIC SYSTEMS
我们用多智能体集群打通人类网络、科学计算与物理系统,把材料发现、性能预测、工程放大到量产排程连成一个模型驱动的闭环。
预约演示01 · THE BOTTLENECK
数据、流程、设备与专家经验先被组织成企业自己的上下文;智能体集群在上下文里理解、决策、行动;结果再回流,让上下文继续长。
01 · 人类经验
专家凭经验给出粗糙假设,知识难以复制。
02 · 科学计算
计算缺少可信数据校准,承担不了筛选。
03 · 物理实验
通量低、方差大,回流数据难以训练模型。
三个要素各自够强,链路却仍然串行—— 真正的卡点是它们之间的路径依赖。

只能交给物理实验穷举

人凭经验给出粗糙假设

回流数据训不了模型,也沉淀不了经验——下一轮从头再来

通量低、方差大、数据不结构化

计算缺可信数据校准,承担不了筛选
只能交给物理实验穷举
人凭经验给出粗糙假设
回流数据训不了模型,也沉淀不了经验——下一轮从头再来
通量低、方差大、数据不结构化
计算缺可信数据校准,承担不了筛选
02 · THREE AUTONOMIES
数据、流程、设备与专家经验先被组织成企业自己的上下文;智能体集群在上下文里理解、决策、行动;结果再回流,让上下文继续长。
AUTONOMOUS HYPOTHESIS 01 人类网络
大模型作为 AI 科学家副驾,内化海量文献与隐性经验,自主完成意图理解、假设生成、方案设计与报告解读。人只主导目标设定与科学判断

AUTONOMOUS COMPUTING 02 科学计算
纯数据驱动的黑盒泛化不住,纯第一性原理算不起。生成筛选模型在庞大材料空间里自主探索,物理神经网络在约束内推理——把下发给物理世界的未知空间压小。

AUTONOMOUS LAB 03 物理系统
以理解真实物理规律的世界模型为基座,结合机器人,物理系统按指令自主完成合成、表征与工艺调优,7×24 小时闭环试错,高质量数据回流。
03 · MICRO · MESO · MACRO
微观科学扩散模型、介观机理模型、通用大模型与世界模型协同工作。微观科学扩散模型、介观机理模型、通用大模型与世界模型作基座,新材料知识库内化隐空间表征,自主实验室做脚手架。
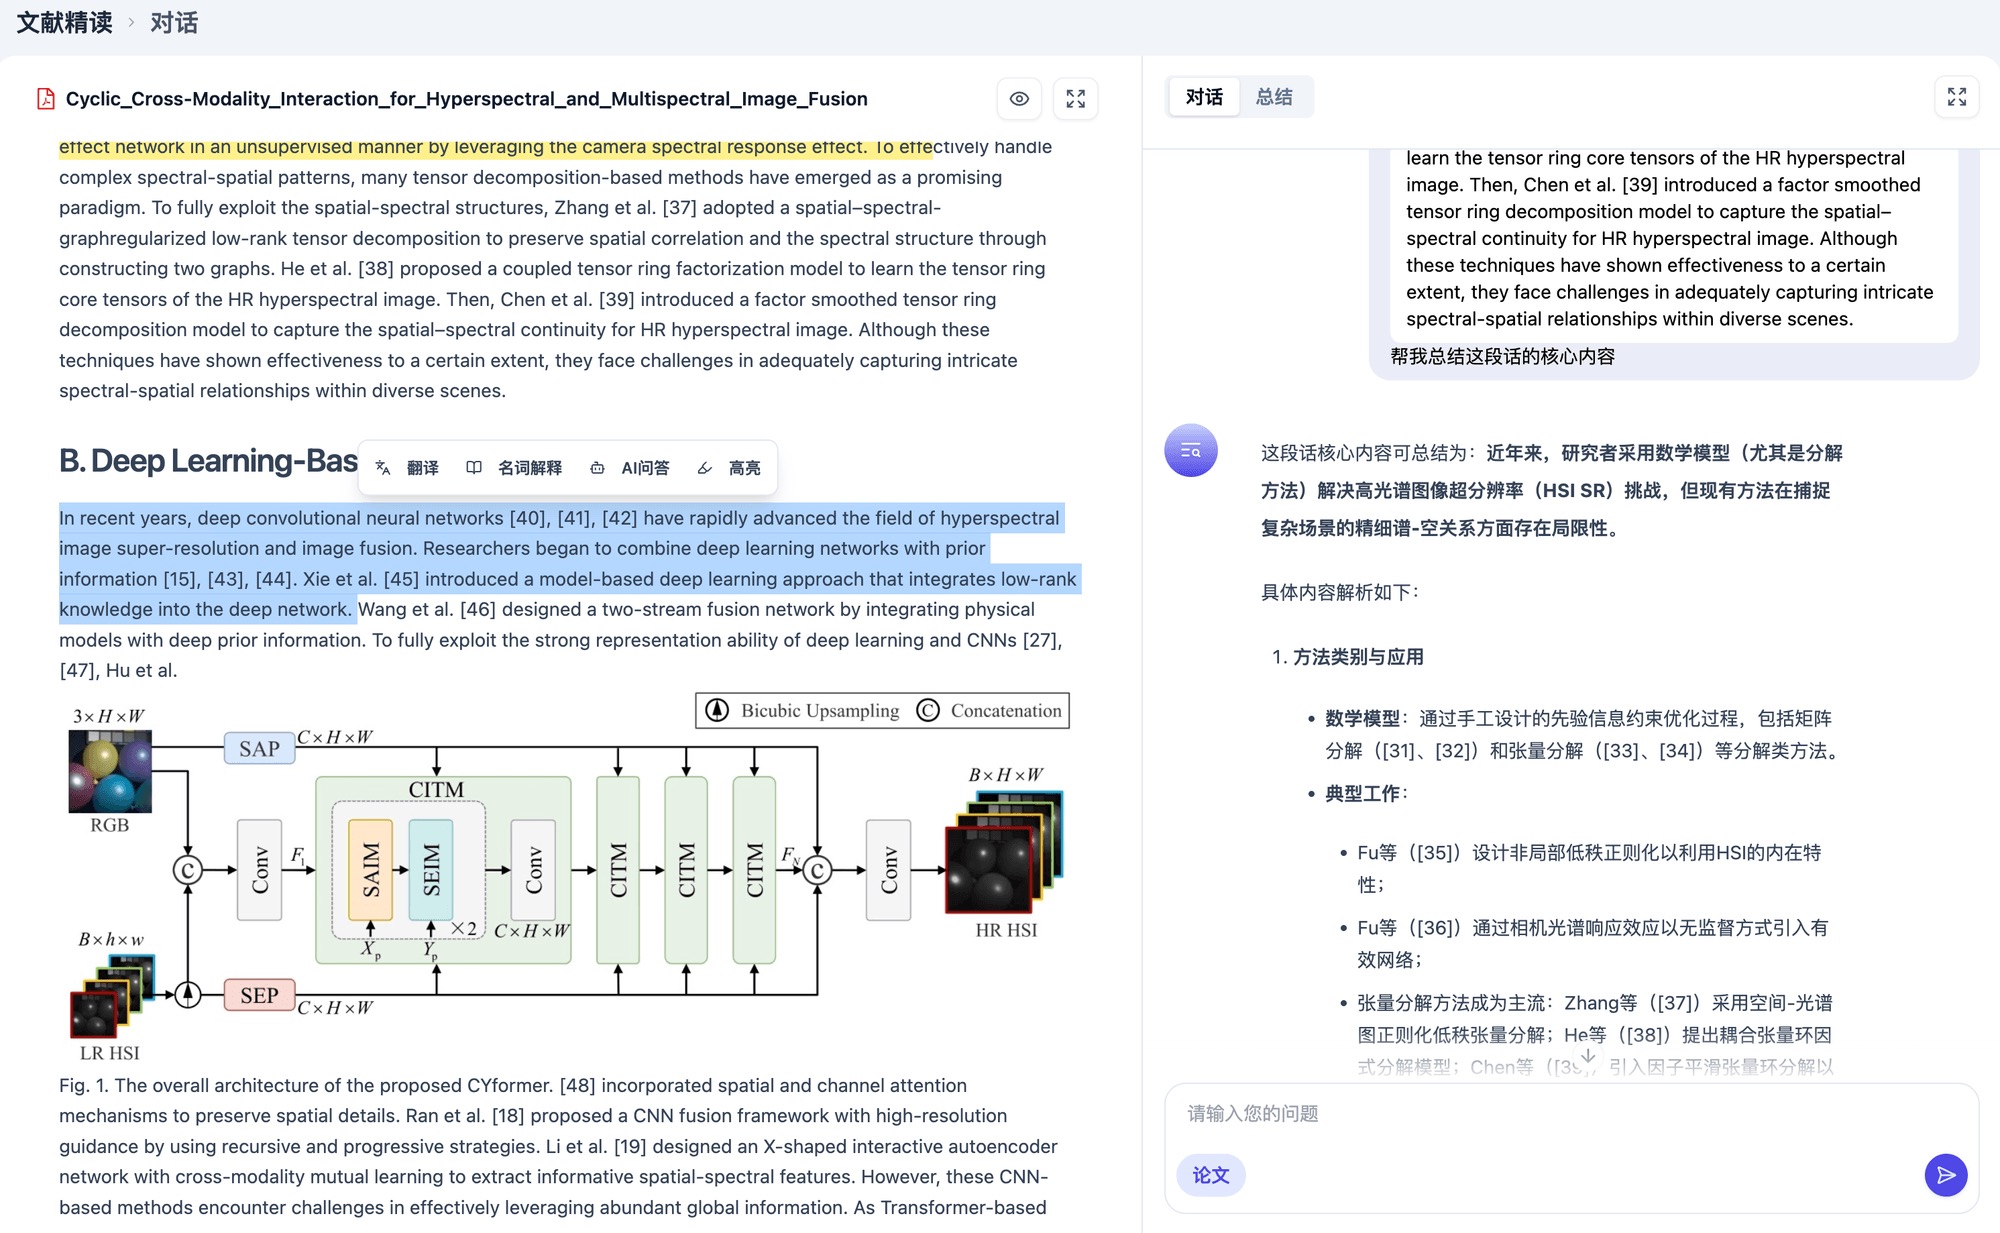
在隐空间重新组织材料表征,目标性质(带隙、催化活性)直接作为条件反向生成候选分子与晶体;势函数作快速代理完成大规模虚拟筛选。
收敛到可承受的量级,再交给实验室验证
复杂工况下的力学、热学、电磁学性能快速给出,也支持由目标性能反推成分与微结构;反应釜传热传质、流化床气固流动同样建模。
仿真从事后校核,变成设计过程中的实时参考
化学过程智能体刻画反应器行为、分离流程与全流程物料能量平衡,识别工艺窗口与放大风险;收率、能耗、成本与交付纳入统一优化。
「能否放大」,在配方阶段就成为可评估的问题
在隐空间重新组织材料表征,目标性质(带隙、催化活性)直接作为条件反向生成候选分子与晶体;势函数作快速代理完成大规模虚拟筛选。
收敛到可承受的量级,再交给实验室验证
04 · A DISCOVERY, END TO END
命题:设计一种高温耐受(140–160°C)、窄 PDI(<2.1)的乙烯 / 1-辛烯共聚催化剂。
海量生成
10,000
低成本粗筛
2,000
逆合成拦截
200
DFT 过渡态精算
50 → 10
宏观桥接
最终配方
海量生成
低成本粗筛
逆合成拦截
DFT 过渡态精算
宏观桥接
10,000
2,000
200
50 → 10
最终配方
后训练大模型提取金属中心(Hf / Ti)、单活性中心、大位阻,并执行专利排雷
扩散 / 分子生成模型组合出上万个物理可行分子,低算力筛选模型剔除立体空间不合理的废料
逆合成路径规划作为核心拦截器:做不出来的,不往下走
极少数精英分子才动用昂贵的第一性原理算力
高通量实验室接住合成、表征与工艺调优,结果回流修正筛选模型
05 · SELF-DRIVING LAB
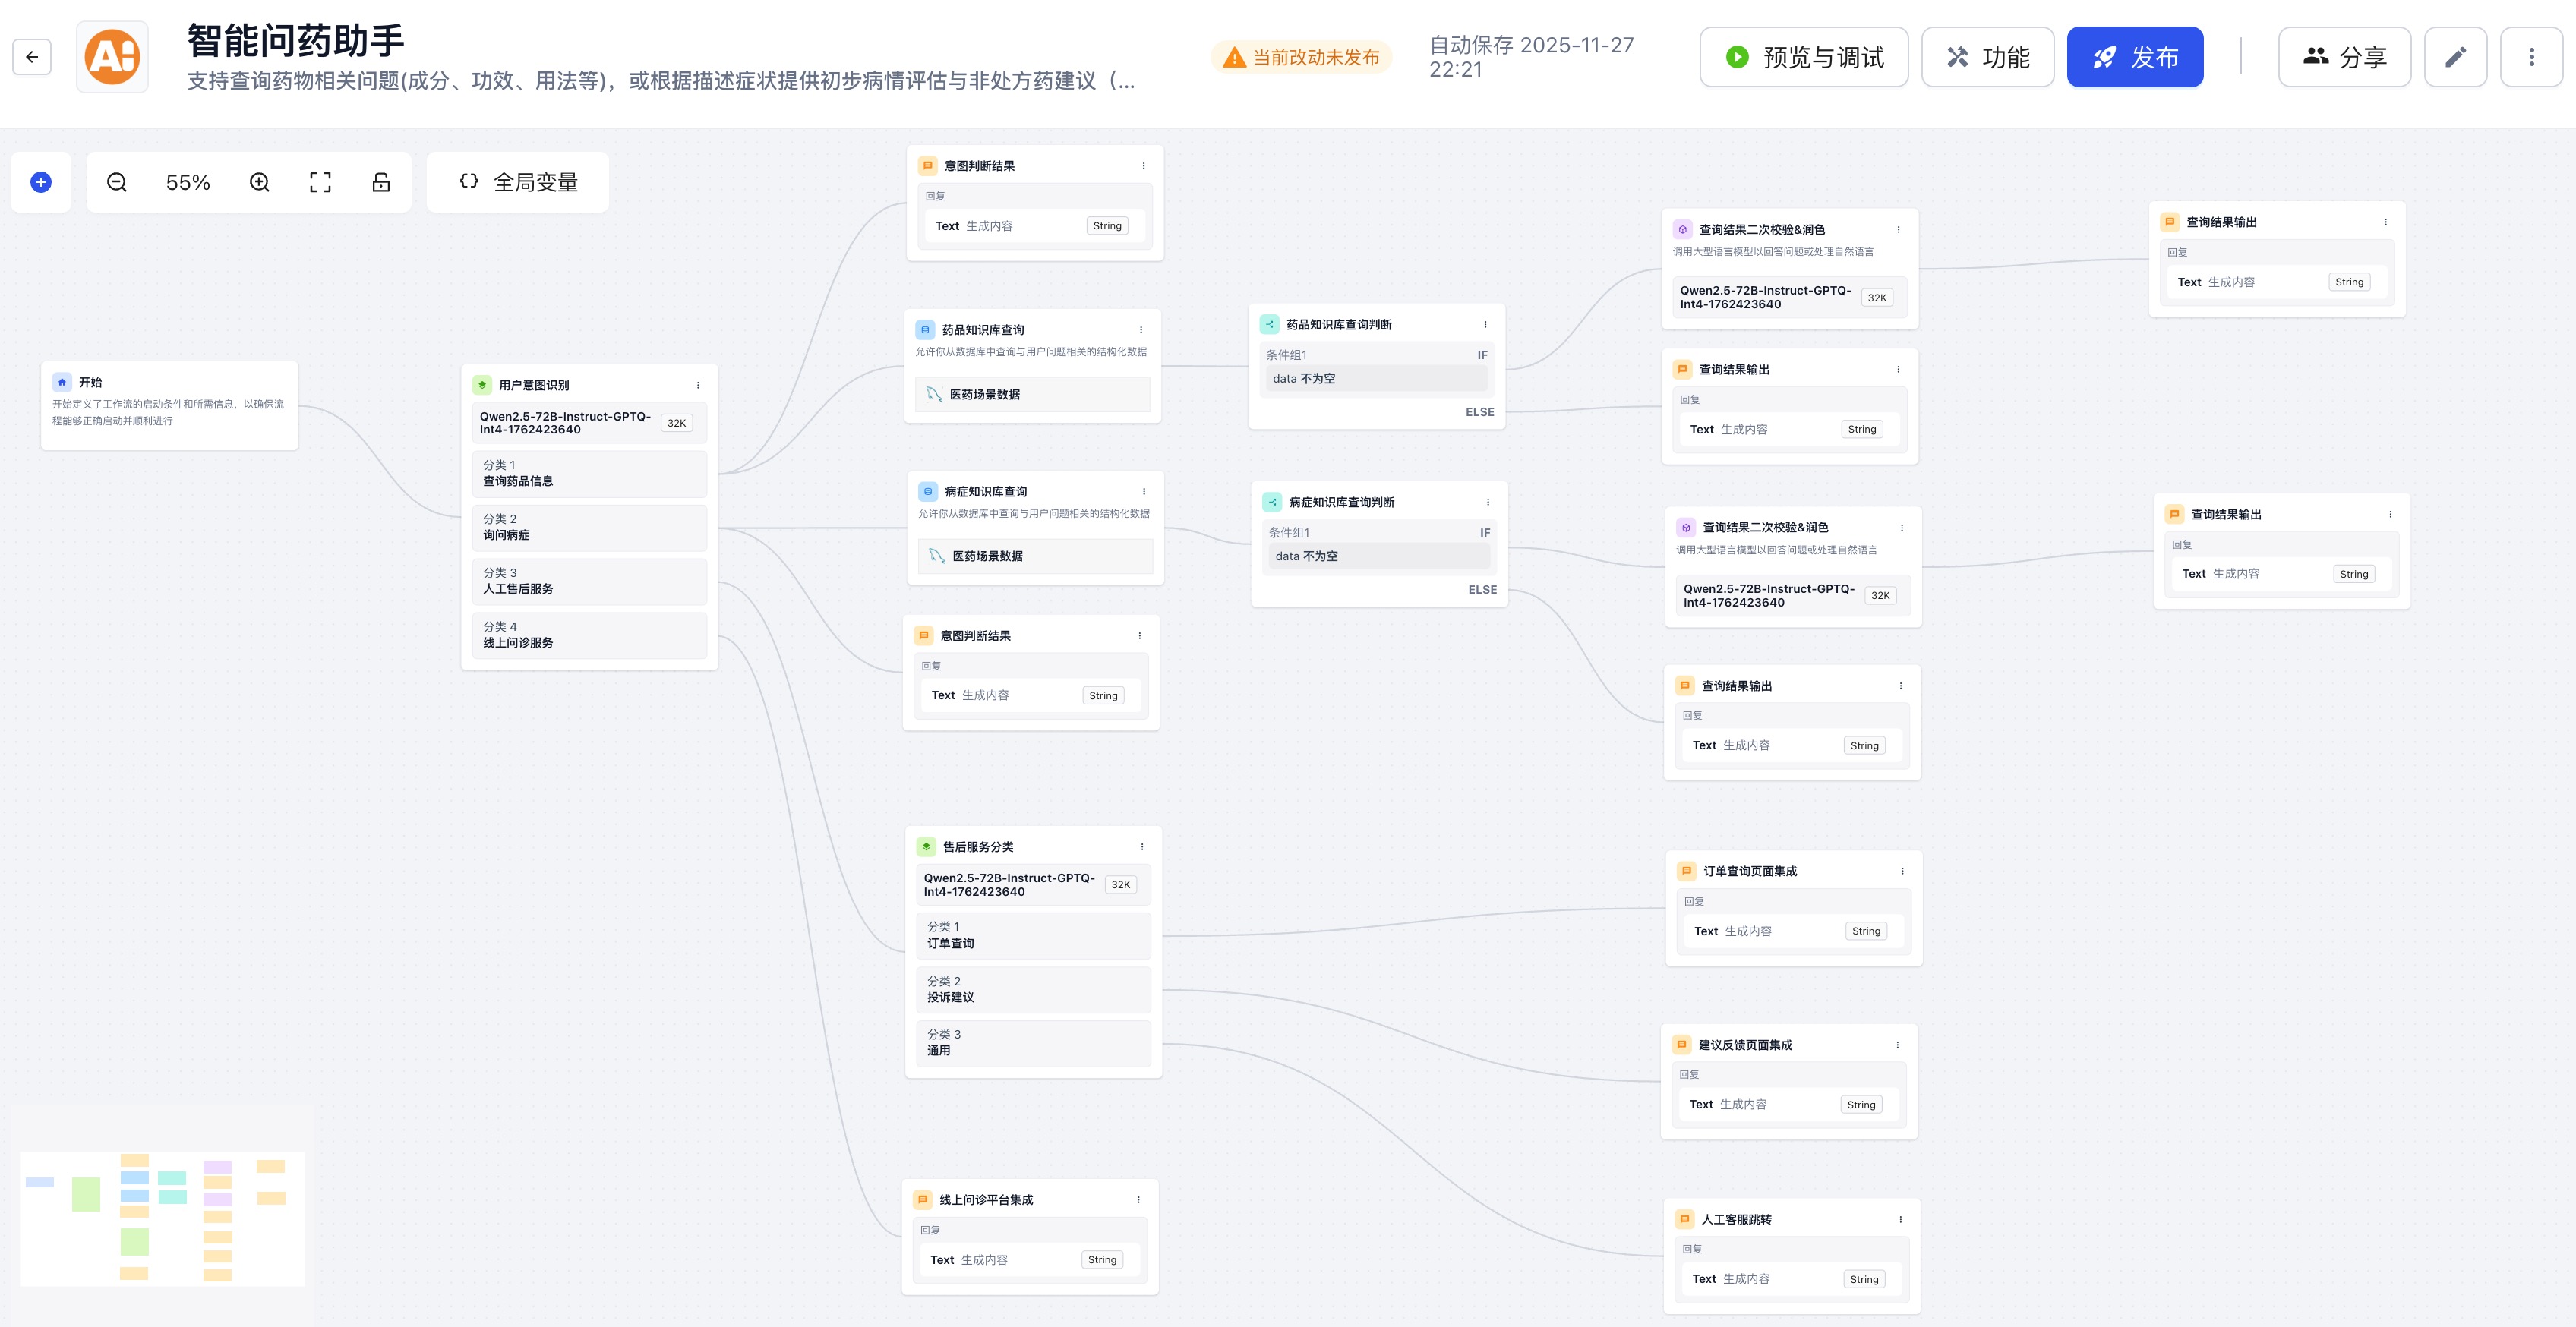
节点是实验任务,边是依赖关系。调度器、资源管理器与设备管理器接住剩下的一切。
POWDER DOSING
系统按配方自动完成前驱体的选择、计量与混合,批量处理同一轮的样品。
16 样品
单任务最大批量
配方来自计算侧的收敛结果,不再由人手抄一遍。
HEATING
普通空气气氛的材料,机器人把坩埚装入陶瓷样品架,整架放进箱式炉执行预设温度程序。
8 样品
单次加热任务批量
与受控气氛管式炉构成两条可选的烧结分支。
HEATING WITH ATMOSPHERE
需要特殊气氛的实验切到管式炉,气体与温度一起被程序控制。
4 样品
受控气氛单批容量
气氛敏感体系必须走这条分支,调度器自动选路。
RECOVER POWDER
烧结冷却后样品送到回收站:取出、破碎、研磨、称量,再转一小份到 XRD 载台。
机械步骤最多
卡料与转移失败的高发环节
任务代码里包含大量异常恢复逻辑——自动化的成本主要在这里。
DIFFRACTION
样品送入粉末 X 射线衍射仪自动采谱,两类分析方法并行处理图谱。
不止 是 / 否
读数直接决定下一轮怎么改
读数不可信,循环就只是在放大噪声。
ENDING
实验结束后结果入库、样品位置更新、日志与元数据留档,数据直接进入模型训练。
全局唯一 ID
每个样品的物理流转历史可追溯
这一步是自主进化的入口:没有归档,就没有复利。
ECOSYSTEM
提出 → 验证 → 读数 → 沉淀。每一轮的结果都回去修正筛选模型、势函数与世界模型,下一轮的未知空间更小。
06 · CONTINUOUS EXPLORATION
提出 → 验证 → 读数 → 沉淀。每一轮的结果都回去修正筛选模型、势函数与世界模型,下一轮的未知空间更小。
1000 → 5
虚拟 rollout 与真实实验
物理世界只做最值得做的那几次
2700s → 0.1ms
单次物理场评估耗时
先让「跑一次」变便宜,并行扇出才成立
7×24
无人值守的闭环试错
通量不再由人的班次决定
01
01 读数变可信
XRD 自动采谱、机器学习识别晶相、Rietveld 精修算质量分数——不只判断有没有生成目标材料,还识别中间相与副产物,为下一轮提供依据。
02
02 模型被自己的实验数据校准
结果入库即用于训练:筛选模型、势函数与介观机理模型持续修正判断,不再靠公开数据集猜。
03
03 经验沉淀成集群的资产
成功路径与失败原因写进知识库与 Skill;第二个体系的立项不用从零开始——这与我们在技术概述里讲的自主迭代是同一套机制。
04
04 跨过企业的围墙
材料基因数据稀缺,而核心数据不会交出去。同一套技术在每家本地建各自的模型;攻克共同课题时组成实验室联盟——自愿参与,成果共享,原始数据不动。